ALBを使うWebサービスで「応答が遅い」と言われたときは、まずどこからどこまでの時間を測るのかを決めます。ターゲットの応答を調べたい場合と、利用者の端末でページが表示されるまでを調べたい場合では、使うデータが異なります。
ALBのアクセスログを使うと、ALBがリクエストを受け取ってから、クライアントへの応答送信を開始するまでの時間を集計できます。この記事では、この区間を測る考え方から、CloudWatchメトリクスとの違い、Athenaでの集計までを説明します。
最初に「応答時間」の開始点と終了点を決める
利用者が操作してから画面を見られるまでには、端末とALBの間の通信、ALBでの処理、ターゲットでの処理、応答データの受信、ブラウザーでの描画などが含まれます。
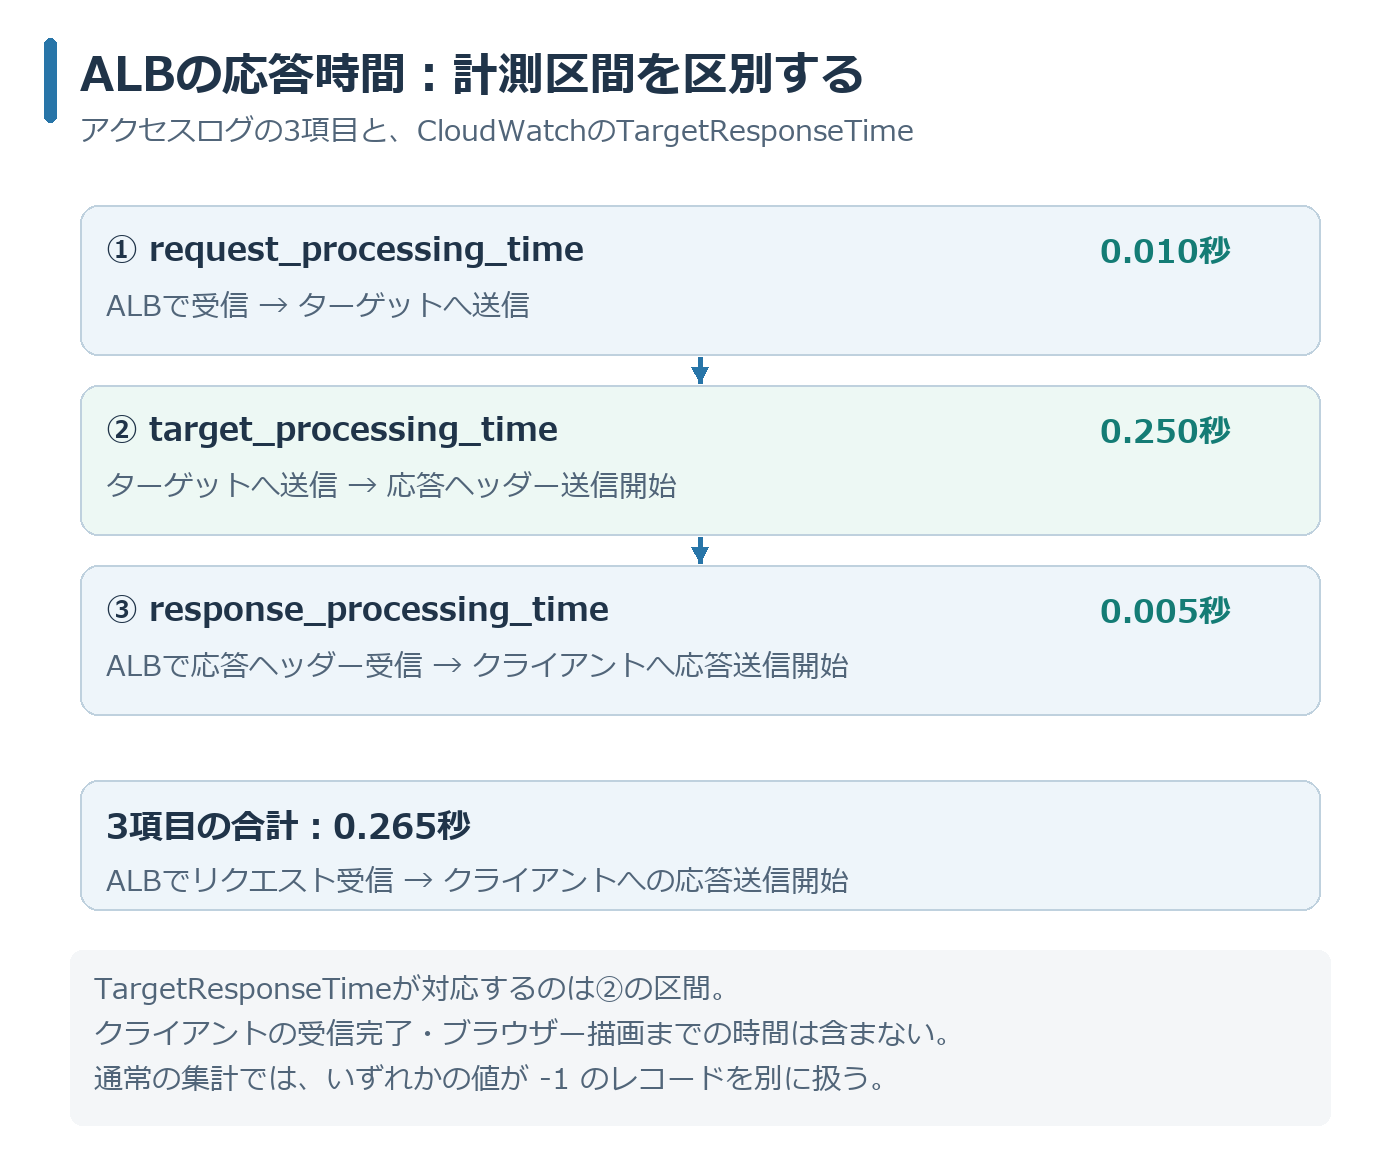
ALBのログで測る今回の区間は、その一部です。開始点はALBでのリクエスト受信、終了点はALBからクライアントへの応答送信開始です。クライアントが応答全体を受信し終えるまでの時間や、画面の描画時間は含みません。
サービスレベル指標(SLI)として使う場合も、「ALBで受信してから応答送信を開始するまでの時間」と名前を付けると、利用者側の体感時間との混同を避けられます。利用者の体験を評価したい場合は、端末側からの計測も組み合わせます。
ALBのログにある3つの時間を足す
この区間を算出するために使うのが、アクセスログの次の3フィールドです。値の単位は秒で、ミリ秒の精度で記録されます。
| フィールド | 時間の区間 |
|---|---|
request_processing_time | ALBがリクエストを受け取ってからターゲットへ送るまで |
target_processing_time | ターゲットへ送ってからターゲットが応答ヘッダーの送信を開始するまで |
response_processing_time | ALBがターゲットの応答ヘッダーを受け取ってからクライアントへの応答送信を開始するまで |
3つの有効な値を合計して、対象区間の時間を求めます。例えば0.010秒、0.250秒、0.005秒なら、合計は0.265秒です。フィールドの定義はAWS公式のALBアクセスログ仕様で確認できます。
タイムアウトなどで値が-1になるレコードは、通常の処理時間として足しません。こうしたレコードは時間集計から除外したうえで、件数やステータスコードを別に調べます。除外した失敗を見えなくすると、遅延の集計だけ良好でもサービスの異常を見落とします。
CloudWatchのTargetResponseTimeとは測る区間が異なる
ログを集計する前に、CloudWatchだけで目的を満たせるかも確認します。ターゲットの応答時間の傾向を見るなら、TargetResponseTimeを利用できます。
このメトリクスは、ALBからリクエストが出てから、ターゲットが応答ヘッダーの送信を開始するまでの時間です。アクセスログのtarget_processing_timeに対応し、前述の3フィールドの合計とは異なります。平均値やパーセンタイルを使った監視ができます。詳細はALBのCloudWatchメトリクス仕様を参照してください。
つまり、ターゲット側の応答傾向を日常監視するならCloudWatch、ALBで受信してから応答送信開始までをリクエスト単位で調べるならアクセスログ、というように目的から選びます。
S3のアクセスログをAthenaで集計する
ここでは、S3に出力するアクセスログをAthenaで調べる構成を使います。手順は「ログを保存する → ログを読み取るテーブルを作る → 対象を絞って集計する」です。
- ALBのアクセスログを有効化し、指定したS3バケットへログが出力されることを確認します。
- AWS公式のAthenaテーブル作成例を使い、
LOCATIONを自分のログ保存先に合わせます。 - 対象ALB、期間、HTTPリクエストの種類を絞って、合計時間の平均やp95を求めます。
以下は、公式例と同じ列名のalb_access_logsテーブルを想定した集計例です。ALBの識別子と日時は例示なので、自分の対象に置き換えてください。日時はUTCで、集計の期間判定にはログのtimeを使います。リクエスト受信日で区切りたい場合は、request_creation_timeを使う設計に変更します。
WITH measured AS (
  SELECT
    request_processing_time
      + target_processing_time
      + response_processing_time AS response_start_seconds
  FROM alb_access_logs
  WHERE type IN ('http', 'https', 'h2')
    AND elb = 'app/example-alb/0123456789abcdef'
    AND from_iso8601_timestamp(time)
        >= from_iso8601_timestamp('2026-09-01T00:00:00Z')
    AND from_iso8601_timestamp(time)
        < from_iso8601_timestamp('2026-09-02T00:00:00Z')
    AND request_processing_time >= 0
    AND target_processing_time >= 0
    AND response_processing_time >= 0
)
SELECT
  count(*) AS measured_requests,
  avg(response_start_seconds) AS average_seconds,
  approx_percentile(response_start_seconds, 0.95) AS p95_seconds
FROM measured;
p95は、おおむね95%の値がその時間以下になる指標で、この例では近似値を返します。平均だけでなく、遅い側のリクエストの傾向を見るために併記します。このSQLは時間を算出できるレコードを対象としており、HTTPの成功応答だけに限定してはいません。
集計後は、時間集計から除外したレコードや5xx応答などを別に確認します。AthenaのALBログクエリ例も参考になります。データ量が多い場合は、日付パーティションなどで読み取り対象を絞り、期間指定だけでスキャン量が減ると思い込まないようにします。
比較するときは、条件と失敗件数も揃える
遅延を比較する際は、同じALB、同じ種類のリクエスト、同じ集計期間で比較します。POSTのデータ送信時間は、AWS WAFの有無やLambdaターゲットなどの条件で計上先が変わるため、target_processing_timeをアプリケーション内部の実行時間だけと解釈しないことも大切です。
また、ALBのアクセスログはベストエフォートであり、すべてのリクエストの完全な台帳として扱う用途には向きません。厳密なSLIを設計する場合は、ログの欠落や時間を算出できないリクエストをどう扱うかも定義します。
可視化は、まずAthenaの結果をCSVで確認し、必要に応じて表計算ソフトなどでグラフ化できます。継続的な監視と個別リクエストの調査を分けると、どの時間が悪化したかを追いやすくなります。